来月の電竜戦に向けてQKNormを追加したモデルの学習を行った。
モデルアーキテクチャとサイズは、世界コンピュータ将棋選手権と同じで、モデルの差分はQKNormを追加しただけである。
訓練データは、終盤の精度を改善するため、終盤局面からNNUE系(氷彗)の自己対局で生成したデータを増やしている。
モデルアーキテクチャ
以前の記事で解説したResNet+Transformerのモデルに、QK RMSNormを追加した。
訓練データ
- dlshogiの自己対局で生成したデータ
- 60ブロック768フィルタのモデルから知識蒸留したデータ
に加えて、NNUE系(氷彗)の自己対局で生成したデータを加えた。
NNUE系の自己対局データ
定跡と棋力計測棋譜からdlshogiが評価を誤っていた約50万局面を抽出した。
それらの局面からランダムにサンプリングした局面を開始局面として、NNUE系(氷彗)で自己対局を行い、MultiPVの評価値から算出した方策の確率分布と、評価値、勝敗をhcpe3として出力した。
10PVで1億ノードで探索して、348万棋譜、2.3億局面を生成した。
訓練データは、重複を平均化して、44.6億局面になった。
精度
評価データセットで評価した精度は以下の通り。
- pre68_40x512 : 世界コンピュータ選手権のモデル
- pre70_40x512 : QKNormを追加した今回のモデル
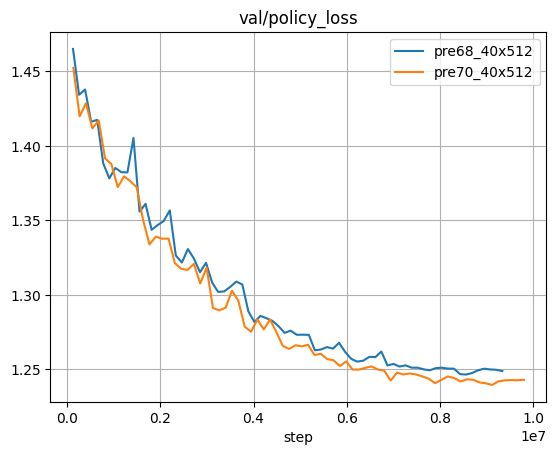
| step | val/policy_loss | |
|---|---|---|
| pre68_40x512 | 9333303 | 1.248792648 |
| pre70_40x512 | 9796439 | 1.242948532 |

| step | val/value_loss | |
|---|---|---|
| pre68_40x512 | 9333303 | 0.707463503 |
| pre70_40x512 | 9796439 | 0.708488047 |
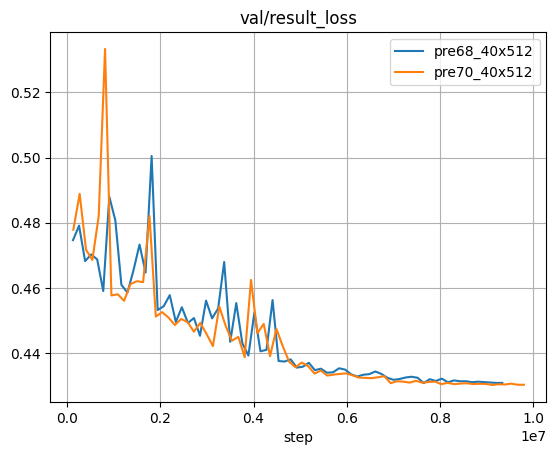
| step | val/result_loss | |
|---|---|---|
| pre68_40x512 | 9333303 | 0.43083781 |
| pre70_40x512 | 9796439 | 0.430271864 |

| step | val/policy_accuracy | |
|---|---|---|
| pre68_40x512 | 9333303 | 0.576049268 |
| pre70_40x512 | 9796439 | 0.577958882 |
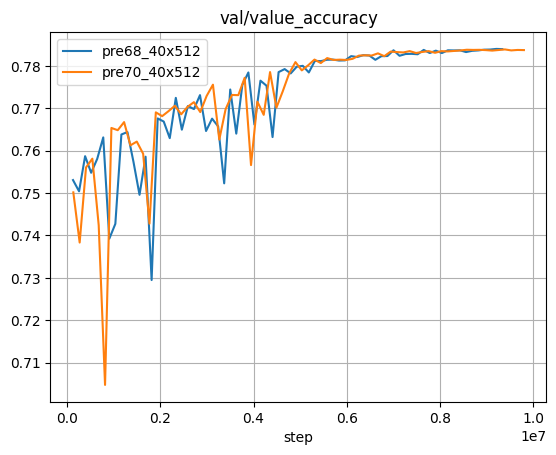
| step | val/value_accuracy | |
|---|---|---|
| pre68_40x512 | 9333303 | 0.783946633 |
| pre70_40x512 | 9796439 | 0.783714056 |
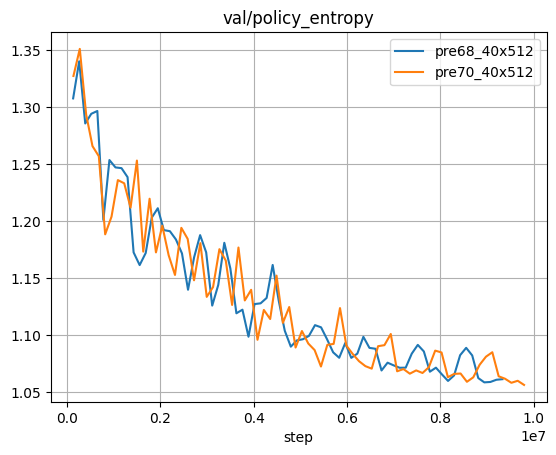
| step | val/policy_entropy | |
|---|---|---|
| pre68_40x512 | 9333303 | 1.061317444 |
| pre70_40x512 | 9796439 | 1.056276321 |

| step | val/value_entropy | |
|---|---|---|
| pre68_40x512 | 9333303 | 0.462144673 |
| pre70_40x512 | 9796439 | 0.461096942 |
方策の正解率が、約0.2%向上している。価値はほぼ同じである。
棋力測定
世界コンピュータ選手権のモデルは、温度パラメータの調整が必要だったため、今回も温度パラメータを変えて測定した。
終盤の精度を測りたいため、終盤互角局面(65万局面)を使用している。
   # PLAYER                  :  RATING  ERROR  POINTS  PLAYED   (%)  CFS(%)     W    D     L  D(%)
   1 hayabusa-8th            :    32.8    7.5  4410.0    7995    55      89  4130  560  3305     7
   2 pre70_40x512_temp180    :    18.5   21.2   500.5     980    51      62   475   51   454     5
   3 pre70_40x512_temp140    :    13.5   21.1   506.0    1003    50      74   461   90   452     9
   4 pre70_40x512_temp150    :     2.7   20.9   497.5    1014    49      56   458   79   477     8
   5 pre70_40x512_temp170    :     0.2   20.8   487.0     999    49      55   456   62   481     6
   6 pre70_40x512_temp190    :    -1.8   20.1   482.0     994    48      66   443   78   473     8
   7 pre70_40x512_temp120    :    -8.1   20.3   472.0     990    48      66   434   76   480     8
   8 pre68_40x512            :   -12.6    7.7  3720.0    8007    46      59  3431  578  3998     7
   9 pre70_40x512_temp130    :   -15.4   21.1   468.5    1002    47      81   441   55   506     5
  10 pre70_40x512_temp160    :   -29.8   21.3   455.5    1014    45     ---   415   81   518     8
温度1.8で、世界コンピュータ選手権のモデルより、R+31.1になっている。
温度1.4もそれと同じ程度の強さである。
8GPUでの強さ
8GPUの場合、最適な温度パラメータが変わる可能性があるため、温度1.8と1.4で比較した。
   # PLAYER                  :  RATING  ERROR  POINTS  PLAYED   (%)  CFS(%)    W    D    L  D(%)
   1 hayabusa-32th           :    11.9   28.2   175.5     339    52      66  165   21  153     6
   2 pre70_40x512_temp140    :     1.4   28.1   170.5     339    50      73  157   27  155     8
   3 pre70_40x512_temp180    :   -13.3   27.6   163.0     340    48     ---  153   20  167     6

White advantage = 204.71 +/- 16.75
Draw rate (equal opponents) = 7.98 % +/- 1.26
8GPUでは、温度1.4の方が強い(CFS 73%)ことがわかった。
32スレッドの氷彗と終盤で互角程度の強さになっている(NN Cacheの改善も含む)。
以前は氷彗と相当差を付けられていたが、終盤精度でもだいぶ追い付くことができた。
dlshogiの弱点であった終盤精度も克服できつつある。
まとめ
来月の電竜戦に向け、ResNet+TransformerにQKNormを追加し、終盤強化用のNNUE系自己対局データを含む44.6億局面で学習した。
従来モデルと比較して方策の正解率が約0.2ポイント向上し、終盤局面での棋力も最大R+31.1改善した。
8GPU環境で、32スレッドの氷彗と終盤でほぼ互角となり、dlshogiの弱点だった終盤精度の改善が確認された。
